
Les agents de code écrivent 30 % de code en plus mais ne livrent pas plus : mesurez le coût par ticket résolu dans la gateway
Une étude de Harvard sur plus de 700 éditeurs logiciels montre que les agents de code augmentent la production de code de 30 % sans améliorer la résolution des tickets, tandis que le temps de revue grimpe. Voici comment router, gouverner et mesurer ce trafic avec Odock pour relier la dépense au travail livré.
À retenir
- 1Les données Harvard et Jellyfish montrent une production en hausse (lignes +30 %, commits +20 %, PR +23 %) et des résultats stables (aucun changement significatif de la résolution Jira), avec un goulot déplacé vers la revue : délai de merge +49 %, commentaires par PR +35 %.
- 2La plupart des entreprises ne savent pas répondre à « combien les agents de code ont-ils coûté par ticket résolu ? », car leur trafic part directement des postes et de la CI vers les providers, avec des clés partagées et sans contexte de ticket.
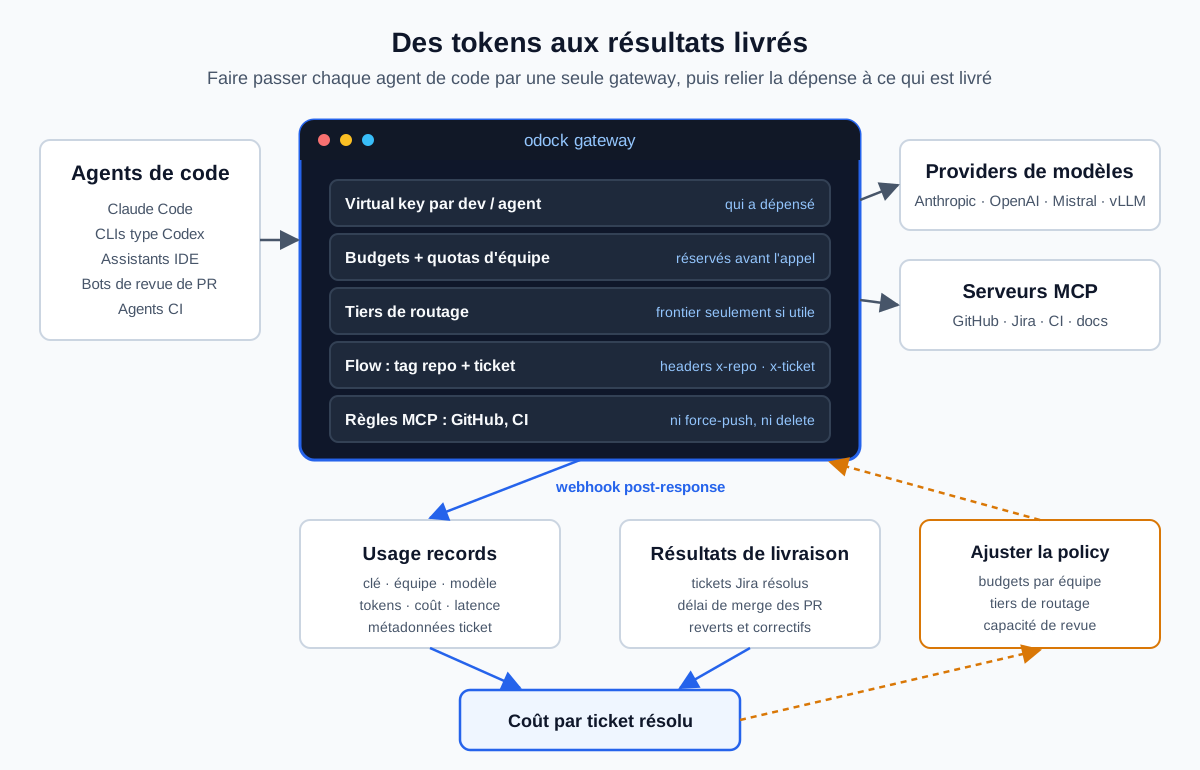
- 3Faire passer chaque agent de code par Odock apporte des virtual keys par développeur et par agent, des budgets d'équipe réservés avant chaque appel, des tiers de routage et des usage records avec coût, modèle et latence.
- 4Un graphe Flow Studio peut marquer chaque requête avec le dépôt et le ticket issus des headers, puis exporter le résultat en asynchrone, pour relier proprement la dépense aux résultats Jira et GitHub.
- 5Les règles d'outils MCP empêchent les agents de « résoudre » le goulot de revue de la mauvaise manière : lire les tickets et ouvrir des PR, oui ; merger, forcer un push ou supprimer une branche, non.
En octobre 2026, un working paper de Harvard construit à partir de la télémétrie Jellyfish et GitHub de plus de 700 éditeurs logiciels a chiffré ce que beaucoup de responsables techniques soupçonnaient. L'adoption d'agents de code a augmenté les lignes de code d'environ 30 %, les commits de 20 % et les pull requests de 23 %. Le taux de résolution des tickets et epics Jira n'a pas bougé. Le délai entre pull request et merge a augmenté de 49 %. Les agents produisent ; l'organisation ne livre pas davantage. Cet article explique pourquoi, et comment transformer le trafic des agents de code en quelque chose que vous pouvez router, budgéter, gouverner et mesurer face aux résultats avec Odock.
Le chiffre que tout le monde a partagé cette semaine
Entre le 9 et le 12 octobre 2026, un graphique a circulé dans tous les Slack d'ingénierie : les agents de code font produire plus de code aux développeurs, et les entreprises ne livrent pas plus de logiciel.
La source est un working paper de Harvard signé par les économistes Fiona Chen et James Stratton, Artificial Intelligence in the Firm: Bottlenecks in Software Production. Il croise la télémétrie d'ingénierie de Jellyfish avec l'activité GitHub de plus de 700 éditeurs logiciels et environ 300 millions d'événements de travail, de 2021 à mars 2026. D'après la couverture de l'étude :
- les lignes de code augmentent d'environ 30 % après l'adoption d'agents de code
- les commits d'environ 20 %, les pull requests d'environ 23 %
- le taux de résolution des tickets Jira et des epics terminés, l'indicateur des auteurs pour les fonctionnalités livrées, ne change pas de manière statistiquement significative
- le délai entre soumission et merge d'une pull request augmente d'environ 49 %, les demandes de révision doublent presque, et les commentaires par pull request augmentent d'environ 35 %
- en mars 2026, 80 % des entreprises utilisaient des outils de revue de code IA, mais seuls 23 % des commentaires de revue étaient générés par l'IA
Certains médias y voient des relecteurs qui travaillent davantage ; d'autres, plus prudents, du travail qui attend plus longtemps en aval. Dans les deux cas, la conclusion est la même : les agents ont déplacé la contrainte. Écrire du code est devenu moins cher. Relire, intégrer et décider, non.
Pourquoi la plupart des entreprises ne le voient pas dans leurs propres données
L'étude s'appuie sur des années de télémétrie d'un fournisseur spécialisé. La plupart des organisations qui tentent de répondre à la même question pour elles-mêmes butent dès le premier jour, car le trafic des agents de code est invisible là où cela compte :
- Il part directement chez les providers. Agents en terminal, assistants d'IDE, bots de revue de PR et agents CI appellent chacun un provider de modèles, souvent avec une clé d'équipe partagée ou une carte personnelle.
- Il n'a pas de contexte métier. Une facture provider indique combien de tokens une clé a consommés. Elle ne dit ni quel dépôt, ni quel ticket, ni quel agent.
- Il n'a pas de plafond. Un agent coincé toute la nuit dans une boucle correction-test-correction dépense jusqu'à ce que quelqu'un remarque la facture.
- Il a des outils. Les agents agissent désormais sur GitHub, Jira et la CI via des serveurs MCP, avec des permissions pensées pour des humains.
Impossible de calculer un coût par ticket résolu si le coût n'est rattaché à aucun ticket. C'est un problème d'infrastructure, et il a une solution d'infrastructure.
Étape 1 : faire passer chaque agent de code par une seule gateway
Odock expose des endpoints natifs pour les formats d'API que les outils de code parlent déjà. La migration se résume à une URL de base et une clé, pas à une réécriture :
- Anthropic Messages sur
https://api.odock.aipour Claude Code et les agents fondés sur le SDK Anthropic - OpenAI Chat Completions et Responses sur
https://api.odock.ai/v1pour les CLIs compatibles OpenAI, les extensions d'IDE et les bots de revue - Mistral, dont le fill-in-the-middle Codestral sur
/v1/mistral/fim/completionspour l'autocomplétion - les endpoints vLLM pour les modèles de code auto-hébergés
- Gemini pour les outils fondés sur Gemini
Pour Claude Code, cela tient en trois variables d'environnement :
export ANTHROPIC_BASE_URL="https://api.odock.ai"
export ANTHROPIC_API_KEY="sk_dock_virtual_key_for_this_developer"
export ANTHROPIC_CUSTOM_HEADERS="x-repo: payments-api
x-ticket: PAY-1423"
Chaque développeur, et chaque agent autonome (le correcteur CI, le relecteur de PR, le bot de dépendances), reçoit sa propre virtual API key. Les clés portent leur propriétaire, leur équipe, leurs grants de modèles et de MCP, leurs budgets et leurs quotas. Les clés provider restent chiffrées dans Odock et n'arrivent jamais sur un poste.
Étape 2 : placer les budgets là où sont les boucles
Les agents de code sont le cas le plus net du paradoxe des coûts agentiques. Gartner a averti en août 2026 que le coût d'inférence des workflows agentiques sera multiplié par plus de cinq en deux ans, même si le prix des tokens baisse, car les agents consomment 5 à 30 fois plus de tokens qu'un chatbot pour une tâche équivalente.
Dans Odock, les budgets s'appliquent à une organisation, une équipe, un utilisateur ou une clé API, et sont appliqués avant l'appel upstream : la gateway estime le coût, le réserve sur chaque budget concerné, puis seulement appelle le provider. Quand une fenêtre est épuisée, l'agent reçoit un 402 budget_exceeded, pas une surprise sur la facture du mois suivant. Les quotas font de même pour le nombre de requêtes et de tokens.
Deux règles pratiques :
- Budgétez les équipes, pas les individus. Un budget d'équipe avec des sous-limites par clé pour les agents autonomes stoppe les boucles sans obliger les développeurs à demander la permission de travailler.
- Donnez aux agents autonomes leurs propres clés et des plafonds plus bas. Un agent CI qui relance indéfiniment un build en échec n'a pas le même profil de risque qu'un développeur qui travaille avec Claude Code.
Pour les agents qui tournent sans surveillance, ajoutez le template de flow intégré Agent identity and loop ceiling d'Odock. Il exige les headers x-odock-agent-id et x-odock-agent-iteration et arrête un agent qui dépasse un nombre de tours fixé, avant qu'il ne dépense plus de tokens.
Étape 3 : marquer chaque requête avec le travail qu'elle sert
C'est la pièce qui rend possible le coût par ticket résolu. L'outil du développeur envoie les headers x-repo et x-ticket (ou votre script d'enveloppe les déduit du nom de branche). Un petit flow Flow Studio fait le reste :
- Pre-route : un nœud Transform copie les headers dans les métadonnées de la requête, pour qu'ils voyagent avec les preuves de la requête.
- Post-response : un nœud Get Response Value lit la consommation de tokens, et un nœud Send Webhook envoie clé, équipe, modèle, tokens, statut, dépôt et ticket vers votre entrepôt. Le post-response s'exécute en asynchrone par défaut : aucune latence pour le développeur.
version: 1
name: Tag coding traffic with repo and ticket
on_error: continue
phases:
  pre_route:
    nodes:
      - {id: start, type: start}
      - id: tag
        type: transform
        config:
          target: request
          operations:
            - {op: set, path: metadata.repo, value: "{{request.headers.x-repo}}"}
            - {op: set, path: metadata.ticket, value: "{{request.headers.x-ticket}}"}
      - {id: end, type: end}
    edges:
      - {from: start, to: tag}
      - {from: tag, to: end}
  post_response:
    nodes:
      - {id: start, type: start}
      - {id: usage, type: response_get, config: {path: body.usage, var: usage}}
      - id: export
        type: webhook_send
        config:
          url: https://warehouse.example.com/hooks/ai-coding-usage
          payload:
            api_key_id: "{{request.api_key_id}}"
            model: "{{request.model}}"
            status: "{{response.status}}"
            usage: "{{vars.usage}}"
            repo: "{{request.headers.x-repo}}"
            ticket: "{{request.headers.x-ticket}}"
            at: "{{now}}"
      - {id: end, type: end}
    edges:
      - {from: start, to: usage}
      - {from: usage, to: export}
      - {from: export, to: end}
Les usage records d'Odock contiennent déjà, pour chaque appel, le principal (organisation, équipe, utilisateur, clé), le provider, le modèle, le statut, la latence, les tokens, le coût, la trace de routage et les résultats des plugins et de la sécurité, sans stocker ni prompts ni réponses. Le flow ajoute la clé métier nécessaire pour les croiser avec Jira et GitHub.
Étape 4 : mesurer les résultats, pas la production
Une fois la dépense marquée par ticket, la jointure dans l'entrepôt est simple. Les métriques qui méritent un tableau de bord sont celles qui, selon l'étude de Harvard, bougent vraiment, ou ne bougent pas :
| Métrique | Source | Ce qu'elle indique |
|---|---|---|
| Coût par ticket résolu | Export Odock croisé avec la résolution Jira | Si la dépense agent achète du travail livré |
| Dépense agent sur tickets non résolus | Même jointure, tickets ouverts ou abandonnés | Où partent les tokens sans résultat |
| Délai entre soumission et merge des PR | GitHub | Si la revue est le goulot |
| Correctifs et reverts après merge | GitHub | Si le code des agents crée du travail en aval |
| Dépense par tier de modèle et par équipe | Usage records Odock | Si les modèles frontier servent là où ils comptent |
Les lignes de code et le nombre de PR n'ont rien à faire sur ce tableau de bord. Tout l'enseignement de l'étude est qu'ils augmentent pendant que les résultats stagnent.
Étape 5 : investir les économies dans le vrai goulot
Si la revue est la contrainte, deux conséquences en découlent.
Router la génération vers le tier le moins cher qui fonctionne. Le routage Odock permet à une clé de définir des candidats, des stratégies et un failover, et un flow pre-route peut rétrograder les requêtes de type boilerplate vers un modèle plus petit. Un modèle de décision comme Jev, appelé depuis Flow Studio, peut classer une requête comme simple ou complexe en environ 100 ms. Voir notre article sur Jev et Flow Studio.
Mesurer la revue IA comme une charge à part entière. Donnez aux bots de revue de PR leurs propres virtual keys et budgets. Si 80 % des entreprises utilisent la revue IA mais que seuls 23 % des commentaires en proviennent, vous voulez savoir ce que cette dépense achète : commentaires acceptés, défauts détectés, temps de revue économisé.
Étape 6 : ne pas laisser les agents supprimer le goulot en supprimant la revue
Il existe un raccourci dangereux pour « corriger » le délai de merge : laisser les agents merger. Avec des serveurs MCP pour GitHub et la CI dans la boîte à outils de chaque agent, ce raccourci n'est qu'à un appel d'outil.
Odock gouverne le trafic MCP par clé :
- Les grants d'accès décident quelles clés peuvent appeler le serveur MCP GitHub ou CI.
- Les outils autorisés cantonnent les agents de code à leur travail : lire les tickets et les fichiers, créer des branches, ouvrir des pull requests, commenter.
- Les outils bloqués gardent les actions irréversibles chez les humains : merge, force-push, suppression de branche, modification des paramètres ou secrets du dépôt.
- Les filtres sémantiques inspectent les payloads des appels d'outils avant exécution.
- L'injection de l'auth upstream garde le token GitHub dans Odock : il n'apparaît jamais dans l'environnement d'un agent.
- Les usage records MCP attribuent chaque appel d'outil à une clé, un serveur, un outil, un statut et un coût.
Pour les actions parfois légitimes, comme un agent qui merge une mise à jour de dépendance dans un dépôt à faible risque, utilisez le template de flow intégré MCP external approval gate : il appelle votre service de policy avant les outils destructifs et échoue fermé si l'approbation est refusée ou indisponible.
Ce que les responsables techniques devraient faire ce trimestre
- Recenser chaque outil de code et chaque agent qui appelle directement un provider, y compris en CI.
- Émettre une virtual key par développeur et par agent autonome ; révoquer les clés provider partagées.
- Définir des budgets d'équipe avec des plafonds plus bas pour les agents sans surveillance ; activer le template de plafond de boucles.
- Ajouter les headers de dépôt et de ticket à la configuration des agents et déployer le flow de marquage.
- Croiser l'export avec Jira et GitHub et publier le coût par ticket résolu, pas les lignes de code.
- Restreindre le serveur MCP GitHub aux outils de lecture, de branche et d'ouverture de PR ; faire passer les merges par des humains ou une gate d'approbation.
Le résultat de Harvard n'est pas un argument contre les agents de code. C'est un argument contre leur exécution sous forme de trafic non géré et non mesuré. Dès que chaque requête porte une identité, un budget, un ticket et une trace, vous voyez où les agents créent de la valeur livrée et où ils ne créent que davantage de code à relire.
Sources
- AI Weekly, Harvard Study: AI Coding Agents Lift Code 30%, Shipped Output Flat
- Tech Insider, AI Coding Agents Add 30% More Code, Not Software
- n8nlab, AI Coding Agents Add Code, Not Software Output, Study Finds
- Superpower Daily, AI coding agents boosted code output without clear task completion gains
- Computerworld, AI inference is getting cheaper, but your agents are getting more expensive, 17 août 2026
- Endpoints natifs Odock
- Budgets Odock
- Usage records Odock
- Sécurité MCP dans Odock
À retenir
- 1
Les données Harvard et Jellyfish montrent une production en hausse (lignes +30 %, commits +20 %, PR +23 %) et des résultats stables (aucun changement significatif de la résolution Jira), avec un goulot déplacé vers la revue : délai de merge +49 %, commentaires par PR +35 %.
- 2
La plupart des entreprises ne savent pas répondre à « combien les agents de code ont-ils coûté par ticket résolu ? », car leur trafic part directement des postes et de la CI vers les providers, avec des clés partagées et sans contexte de ticket.
- 3
Faire passer chaque agent de code par Odock apporte des virtual keys par développeur et par agent, des budgets d'équipe réservés avant chaque appel, des tiers de routage et des usage records avec coût, modèle et latence.
- 4
Un graphe Flow Studio peut marquer chaque requête avec le dépôt et le ticket issus des headers, puis exporter le résultat en asynchrone, pour relier proprement la dépense aux résultats Jira et GitHub.
- 5
Les règles d'outils MCP empêchent les agents de « résoudre » le goulot de revue de la mauvaise manière : lire les tickets et ouvrir des PR, oui ; merger, forcer un push ou supprimer une branche, non.
Questions fréquentes
Qu'a montré l'étude de Harvard sur les agents de code ?
Le working paper de Fiona Chen et James Stratton, fondé sur la télémétrie Jellyfish et les signaux GitHub de plus de 700 éditeurs logiciels jusqu'en mars 2026, montre que l'adoption d'agents de code augmente les lignes de code d'environ 30 %, les commits de 20 % et les pull requests de 23 %, sans changement significatif de la résolution des tickets et epics Jira. Le délai entre soumission et merge d'une PR augmente d'environ 49 % et les commentaires par PR d'environ 35 %.
Claude Code et les autres agents de code peuvent-ils passer par Odock ?
Oui, pour les outils qui permettent de définir une URL de base. Odock expose des endpoints natifs Anthropic Messages, OpenAI Chat Completions et Responses, Gemini, Mistral dont le fill-in-the-middle Codestral, et vLLM. Pointez l'URL de base de l'outil vers Odock et utilisez une virtual API key Odock à la place de la clé provider.
Comment attribuer la dépense IA de développement aux tickets ?
Faites envoyer à l'agent des headers de dépôt et de ticket, par exemple avec ANTHROPIC_CUSTOM_HEADERS dans Claude Code. Un flow pre-route les copie dans les métadonnées de la requête, et un flow post-response envoie modèle, tokens, statut et ticket vers votre entrepôt via un webhook. Croisez ensuite avec les données de résolution Jira pour obtenir le coût par ticket résolu.
Faut-il plafonner la dépense des agents de code ?
Plafonnez-la par équipe avec des budgets, pas à la main par développeur. Odock réserve le coût estimé avant l'appel upstream et renvoie un 402 budget_exceeded explicite quand une fenêtre est épuisée, ce qui stoppe les boucles d'agents sans bloquer le reste de l'organisation.
Pourquoi gouverner le serveur MCP GitHub ?
Parce que le goulot est la revue. La façon la plus rapide de rendre un agent « productif » est de le laisser merger ses propres pull requests. Les allowlists et blocklists d'outils MCP cantonnent les agents à la lecture, aux branches et à l'ouverture de PR, tandis que merges, force-push et suppressions restent aux humains.
Sachez ce que coûte chaque agent de code, et ce qu'il a livré
Odock donne à chaque développeur et à chaque agent une virtual key, applique les budgets d'équipe avant l'appel, gouverne les outils GitHub et CI via MCP et enregistre coût et résultat pour chaque requête.
Articles liés
Comment contrôler les coûts LLM avec des clés API virtuelles, des budgets et des quotas
Le moyen le plus rapide de perdre le contrôle de l’économie IA consiste à laisser chaque service appeler directement les providers avec des identifiants partagés. Cet article présente le modèle opérationnel dont les équipes ont besoin à la place.
Lire l'articleQue logger, monitorer et tracer dans les applications LLM en production
Quand le trafic IA traverse providers, outils, tenants et équipes, l’observabilité doit relier qualité, latency, coût, sécurité et décisions de routing.
Lire l'articleGouvernance des serveurs MCP : donner accès aux outils aux agents IA sans perdre le contrôle
Les agents deviennent plus puissants lorsqu’ils peuvent appeler des outils. Ils deviennent aussi plus risqués si les permissions, les traces d’audit et les contrôles de politique ne sont pas centralisés dans un gateway.
Lire l'articleJev rencontre la gateway : des décisions IA en millisecondes avec Flow Studio et les plugins Odock
Jev est le premier modèle de décision « System One » : des réponses typées avec probabilités, sans texte généré. Placé dans la gateway avec Flow Studio, il donne à chaque requête, étape d'agent et appel d'outil MCP une décision rapide, peu coûteuse et auditable.
Lire l'article