
Jev rencontre la gateway : des décisions IA en millisecondes avec Flow Studio et les plugins Odock
Jev, de TypeSafe, répond à des questions typées en environ 100 ms pour une fraction du coût d'un LLM. Voici comment le brancher sur Flow Studio et les plugins Odock pour router les modèles, contrôler les appels d'outils MCP et escalader les cas incertains.
À retenir
- 1Jev est un modèle de décision, pas un modèle de chat : réponses typées Choice, Score et oui/non avec probabilités, environ 70 à 500 ms, 0,042 $ par million de tokens d'entrée, tokens de sortie gratuits (chiffres TypeSafe).
- 2Une grande partie des tokens frontier consommés par les agents sert à des décisions. Les confier à un modèle System One et agir dessus dans la gateway réduit coût et latence sans toucher au code applicatif.
- 3Flow Studio fournit la plomberie : HTTP Request pour interroger Jev, Switch et If pour brancher, Route Model pour choisir le tier, Abort ou un appel d'approbation pour stopper les actions risquées, et Run Plugin pour masquer les données avant leur sortie.
- 4Une décision prise dans la gateway s'applique à tous les clients et laisse des preuves : traces de flow, usage records et usage records MCP reliés par un même request id.
- 5Jev est un filtre, pas une frontière de sécurité : gardez d'abord les contrôles déterministes (grants, allowlists, budgets, SafetySec) et prévoyez un comportement sûr si le service de décision est lent ou indisponible.
En septembre 2026, TypeSafe AI a publié Jev, un modèle qui n'écrit pas de texte. Vous lui donnez un état et une question typée ; il renvoie un choix, un score ou une probabilité oui/non en environ un dixième de seconde. C'est exactement la forme de la plupart des décisions dans un workflow IA : quel modèle, quel traitement, cet appel d'outil est-il sûr, faut-il un humain. Cet article montre comment exécuter ces décisions là où passe déjà chaque requête, dans la gateway Odock, avec des graphes Flow Studio et des plugins, pour qu'elles soient rapides, peu coûteuses, appliquées et tracées.
Pourquoi un modèle qui ne sait pas écrire fait autant parler
Le 15 septembre 2026, TypeSafe AI est sorti de l'ombre avec une levée seed de 40 millions de dollars menée par DCVC et a publié en accès anticipé son premier modèle public, Jev. En un mois, il avait déjà ses conférences, ses articles explicatifs et un sujet tendance sur les agents qui décident plus vite.
La raison est simple : Jev ne génère pas de texte. TypeSafe parle d'un modèle « System One ». Vous envoyez un état non structuré, texte ou JSON, avec une série de questions typées, et il renvoie des réponses typées accompagnées de probabilités :
- Choice : choisir une option parmi jusqu'à 255, avec une probabilité par option et une valeur de confiance
- Score : placer l'état sur une échelle ordonnée de 2 à 10 niveaux
- Noul : une question oui/non qui renvoie la probabilité du « oui »
Toutes les questions d'un même appel sont évaluées en parallèle sur le même état. TypeSafe annonce 70 à 500 ms de bout en bout et un prix de 0,042 $ par million de tokens d'entrée, les tokens de sortie étant gratuits. Les premiers utilisateurs rapportent des gains concrets : un article estime à environ 6 $ la notation d'un million d'avis avec Jev contre environ 1 050 $ avec un modèle frontier, et Good Start Labs a mesuré 91,5 % d'accord avec les verdicts de Claude sur 6 003 vérifications de grille.
Les limites comptent autant que les chiffres. La plupart des données viennent de TypeSafe ou des premiers utilisateurs. Jev est uniquement hébergé, en accès anticipé, sur liste d'attente. Il ne peut pas chercher de données en direct, ni écrire de prose ou de code, et un schéma garantit une réponse bien formée, pas une réponse juste. Dans l'évaluation de TypeSafe lui-même, il reste derrière les meilleurs modèles frontier en précision. C'est un juge rapide, bon marché et calibré, pas un cerveau plus intelligent.
C'est précisément pour cela qu'il a sa place dans l'infrastructure.
L'essentiel de la dépense agentique sert à décider
Regardez ce que fait un agent entre les étapes intéressantes. Il classe une intention. Il choisit un outil. Il juge si un résultat est suffisant. Il décide de réessayer, d'escalader ou de s'arrêter. Chacune de ces étapes est une question avec un petit ensemble de réponses connues, et la plupart des équipes y répondent en appelant un modèle frontier puis en analysant son texte.
Ce schéma coûte cher de trois façons :
- Le coût. Gartner a averti en août 2026 que, si le prix des tokens continue de baisser, le coût d'inférence des workflows agentiques sera multiplié par plus de cinq en deux ans, car les agents consomment 5 à 30 fois plus de tokens qu'un chatbot pour une tâche équivalente.
- La latence. Un modèle frontier à qui l'on demande « juste de décider » prend quand même plusieurs secondes. Un routeur bâti sur un LLM-juge peut ajouter 1 à 5 secondes à chaque requête.
- L'incohérence. Quand la décision vit dans le prompt de chaque application, chaque équipe implémente routage, escalade et approbation d'outils à sa manière, et rien n'apparaît dans une piste d'audit unique.
Un modèle System One règle les deux premiers points. La gateway règle le troisième.
Pourquoi la décision doit vivre dans la gateway
Vous pourriez appeler Jev depuis le code applicatif, et beaucoup d'équipes le feront. Mais les décisions qui comptent le plus pour une entreprise n'appartiennent pas à une seule application :
- quel tier de modèle une requête a le droit d'utiliser
- si l'appel d'outil d'un agent est cohérent avec la tâche reçue
- quand un humain doit intervenir
- ce qui est enregistré pour l'audit
Ce sont des décisions de plateforme. Dans Odock, chaque appel de modèle et chaque appel d'outil MCP passe déjà par un même cycle de vie : authentifier, autoriser, inspecter, réserver le budget, router, enregistrer. Flow Studio permet d'insérer votre propre logique à quatre phases de ce cycle (pre-route, pre-upstream, post-upstream, post-response) sous forme de graphe de nœuds visuel ou YAML. Les plugins du Marketplace s'exécutent aux mêmes phases et peuvent être invoqués depuis un flow.
Placez Jev à cet endroit et vous obtenez des propriétés que le code applicatif ne peut pas offrir :
- Appliqué à tous les clients. Le bot de support, le copilot interne et les workers agents reçoivent le même routage et le même contrôle d'outils, sans changement de code.
- Combiné aux contrôles déterministes. Grants d'accès, allowlists et blocklists d'outils MCP, budgets, quotas et SafetySec continuent de s'exécuter. Jev ajoute du jugement par-dessus ; il ne remplace pas la policy.
- Tracé. Chaque exécution de flow laisse une trace nœud par nœud (nœud, résultat, durée) attachée aux preuves de la requête, à côté de l'usage record de l'appel.
- Réversible. Les flows vivent dans une bibliothèque et ne s'exécutent qu'une fois activés, sur une seule clé API pour un pilote ou pour toute l'organisation. Les désactiver prend effet dès la requête suivante.
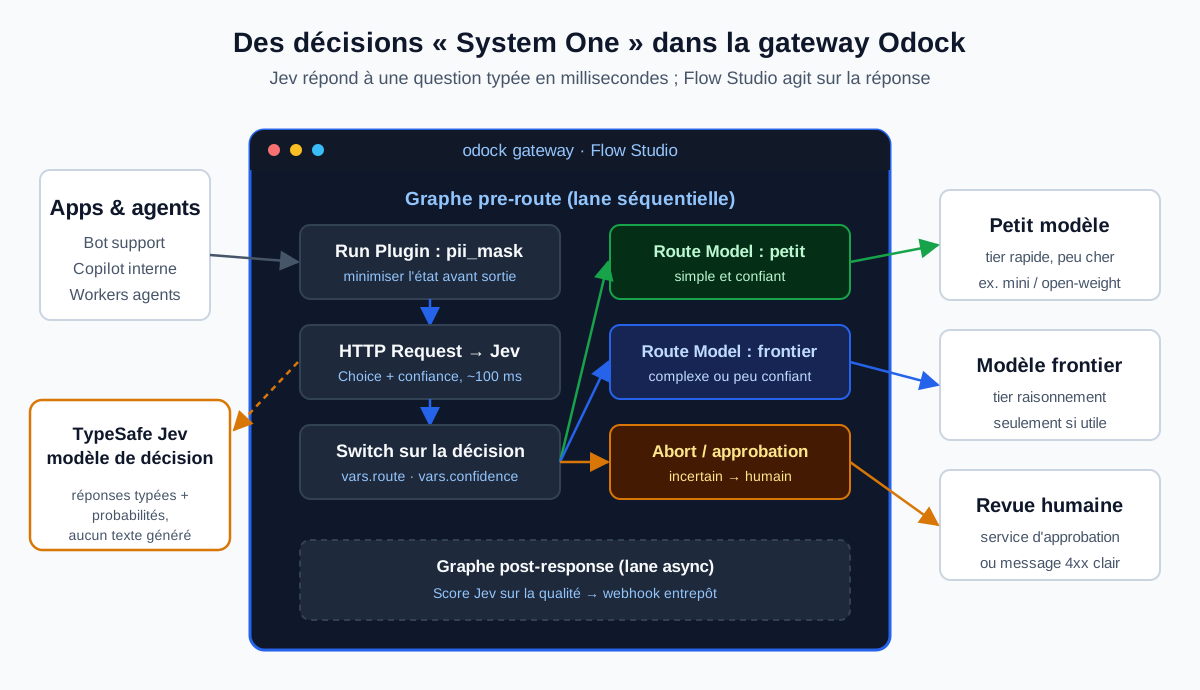
Schéma 1 : un routage de modèle qui tient compte de la confiance
Le gain le plus rapide est le routage. Au lieu d'envoyer chaque requête au modèle frontier codé en dur par un développeur, posez à Jev une question Choice en pre-route et laissez Flow Studio réécrire le modèle cible.
Le graphe :
1. Run Plugin pii_mask pour minimiser l'état envoyé à l'extérieur. 2. HTTP Request vers votre relais de décision, avec les messages de l'utilisateur comme état et une question Choice : simple, complex, needs_human, other. 3. If la confiance est d'au moins 0,8, aller vers un Switch sur le choix. Sinon, garder le modèle frontier. 4. Switch : simple va vers Route Model avec le petit tier, needs_human vers un circuit d'approbation, tout le reste passe sans changement. 5. La sortie error du HTTP Request va directement vers End : si le service de décision est lent ou indisponible, la requête garde le modèle demandé.
En YAML, la structure ressemble à ceci. L'URL du relais et les chemins de champs de réponse sont illustratifs ; adaptez-les au relais que vous déployez et à la référence API actuelle de TypeSafe.
version: 1
name: Jev confidence-aware routing
on_error: continue
phases:
  pre_route:
    nodes:
      - {id: start, type: start}
      - {id: mask, type: plugin_call, config: {slug: pii_mask}}
      - id: jev
        type: http_request
        config:
          method: POST
          url: https://decisions.internal.example.com/v1/route
          body:
            state: "{{request.body.messages}}"
            question: {type: choice, options: [simple, complex, needs_human, other]}
          timeout_ms: 800
      - id: confident
        type: if
        config:
          conditions:
            - {left: "{{nodes.jev.body.confidence}}", op: gte, right: 0.8}
      - id: decide
        type: switch
        config:
          value: "{{nodes.jev.body.choice}}"
          cases:
            - {equals: simple}
            - {equals: needs_human}
      - {id: small, type: model_route, config: {model: gpt-4.1-mini}}
      - id: escalate
        type: abort
        config:
          status: 409
          code: flow.needs_human
          message: "Cette demande nécessite une revue humaine. Elle a été mise en file."
      - {id: end, type: end}
    edges:
      - {from: start, to: mask}
      - {from: mask, to: jev}
      - {from: jev, to: confident}
      - {from: jev, to: end, handle: error}
      - {from: confident, to: decide, handle: "true"}
      - {from: confident, to: end, handle: "false"}
      - {from: decide, to: small, handle: simple}
      - {from: decide, to: escalate, handle: needs_human}
      - {from: decide, to: end, handle: default}
      - {from: small, to: end}
Quelques détails font passer ce schéma de la démo à la production :
- Le routage respecte toujours les grants. Route Model réécrit la cible, mais ce sont les grants d'accès d'Odock qui décident si la clé peut appeler ce modèle. Un flow ne peut pas router une clé vers un modèle qui ne lui a jamais été accordé.
- Les budgets voient le vrai modèle. La réservation de budget a lieu après le pre-route : l'estimation porte donc sur le modèle réellement appelé.
- Le comportement par défaut est sûr. Une confiance faible ou une erreur conserve le modèle d'origine. Vous n'économisez que lorsque la décision est confiante.
C'est le schéma que Gartner recommande sous le nom d'« inference tiering », qui consiste à empêcher les agents d'utiliser par défaut des modèles frontier pour des tâches simples, implémenté une seule fois pour toute l'organisation.
Schéma 2 : contrôler les appels d'outils MCP
L'usage le plus important d'un juge rapide n'est pas d'économiser, mais d'empêcher la mauvaise action. L'exemple classique de la communauté Jev : npm run db:reset est la bonne commande si la tâche est « réinitialiser ma base locale » et une catastrophe si la tâche est « ajouter une colonne ».
Des règles statiques ne savent pas faire la différence. Une allowlist d'outils autorise db.reset ou ne l'autorise pas. Un jugement, lui, peut distinguer les deux cas.
Odock fournit déjà les couches déterministes pour le trafic MCP : un grant d'accès MCP par clé, un scope par équipe ou par clé, des outils autorisés et bloqués, des filtres sémantiques sur les payloads, l'injection de l'auth upstream pour que les agents ne voient jamais les secrets, ainsi que budgets et quotas. Gardez tout cela. Ajoutez ensuite un flow pre-upstream pour le petit ensemble d'outils à fort impact :
1. If {{request.metadata.mcp_method}} vaut tools/call et {{request.metadata.mcp_tool}} figure dans votre liste d'outils à fort impact. 2. HTTP Request vers le relais de décision avec deux éléments d'état : la tâche confiée à l'agent (envoyée par l'agent dans un header comme x-agent-task) et l'action en attente, nom de l'outil plus {{request.body.params.arguments}}. Une question oui/non : « Cette action est-elle cohérente avec la tâche ? » 3. Probabilité d'au moins 0,9 : on continue. Entre 0,5 et 0,9 : appel à votre service d'approbation, comme dans le template intégré MCP external approval gate d'Odock. Sous 0,5 : Abort avec un 403 et un message clair que l'agent peut exploiter. 4. La sortie error du HTTP Request va vers un Abort en 503. Pour les outils destructifs, on échoue fermé.
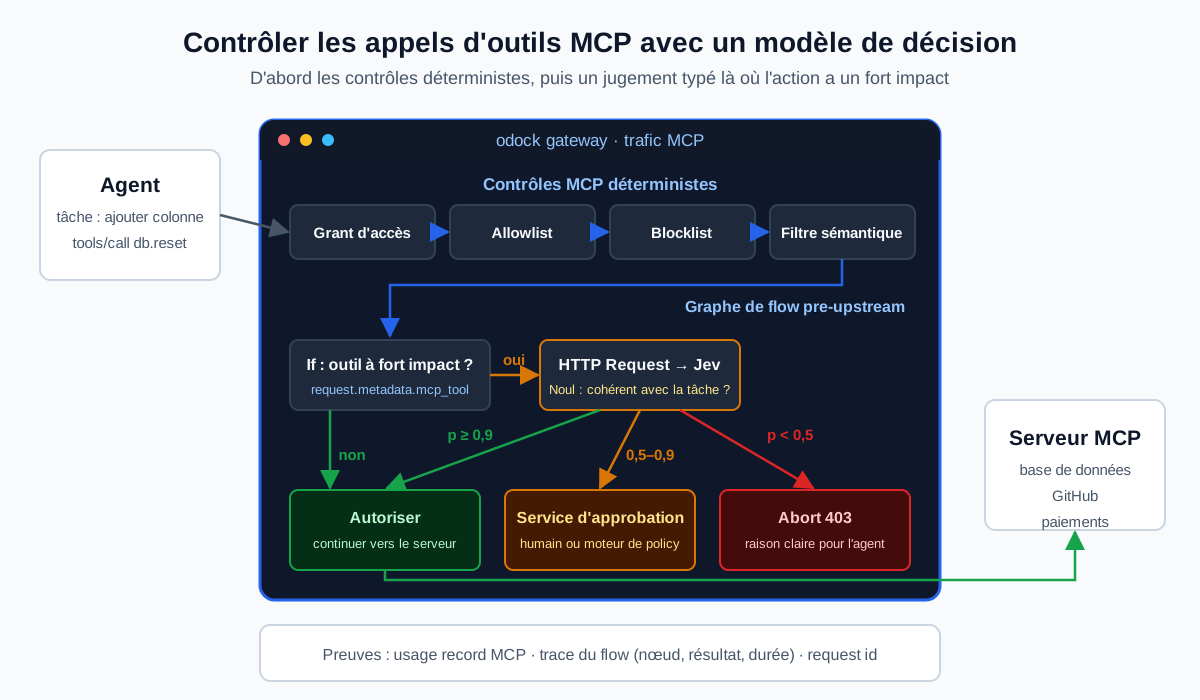
Deux règles de conception issues des premiers utilisateurs de Jev s'appliquent directement :
- Le contrôle voit la tâche et l'action en attente, jamais la sortie de l'outil. C'est dans la sortie des outils que se loge l'injection de prompt indirecte. Gardez-la hors de l'état transmis au juge.
- C'est un filtre, pas une frontière. Jev ne considère pas son entrée comme hostile. C'est pour cela qu'il se place derrière les grants, allowlists, blocklists et filtres sémantiques, et non à leur place.
Chaque décision arrive dans les usage records MCP et les traces de flow d'Odock avec le même request id. Un relecteur sécurité voit ainsi quelle clé agent a demandé quel outil, ce que Jev a répondu et ce que la gateway a fait.
Schéma 3 : une escalade pilotée par la confiance
Des probabilités calibrées changent la conception du human-in-the-loop. Au lieu de tout relire ou de ne rien relire, utilisez trois zones :
- Confiance élevée : action automatique.
- Confiance moyenne : nouvel essai avec plus de contexte ou un modèle plus fort, avec une limite finie.
- Confiance faible : escalade vers une personne.
Dans Flow Studio, cela tient en un Switch ou deux nœuds If après le HTTP Request. Combinez-le avec le template intégré Agent identity and loop ceiling d'Odock, qui exige les headers x-odock-agent-id et x-odock-agent-iteration et arrête les boucles incontrôlées après un nombre de tours fixé : un nouvel essai en confiance moyenne ne peut jamais tourner indéfiniment.
L'essentiel est la mesure. Avant de faire confiance aux seuils, faites tourner le flow en mode shadow : il enregistre la décision sans agir, vous étiquetez 100 à 200 cas réels, puis vous vérifiez si une confiance de 0,9 correspond vraiment à 90 % de bonnes réponses sur votre trafic. Ensuite seulement, activez les chemins automatiques.
Schéma 4 : une notation gratuite après la réponse
La phase post-response s'exécute en asynchrone par défaut. Elle ne peut pas modifier ce que l'appelant a reçu et n'ajoute aucune latence. C'est l'endroit idéal pour noter la qualité :
- lire la sortie du modèle avec un nœud Get Response Value
- demander à Jev un Score (par exemple, la complétude de la réponse de 1 à 5) et un Noul (la réponse donne-t-elle un conseil médical ou juridique ?)
- envoyer le résultat avec un nœud Send Webhook vers votre entrepôt de données ou votre pipeline d'évaluation
Vous obtenez une évaluation continue sur le trafic réel pour quelques centimes, et vous pouvez comparer la qualité par tier de modèle pour vérifier que le schéma 1 route correctement.
Plugins, flows et Jev : qui fait quoi
L'architecture la plus propre laisse chaque composant sur ce qu'il fait le mieux :
| Composant | Rôle | Exemple |
|---|---|---|
| Grants d'accès, budgets, quotas | Policy déterministe | La clé X peut appeler ces modèles et serveurs MCP, dans cette limite de dépense mensuelle |
| SafetySec | Sécurité des prompts et réponses | Injection de prompt, jailbreak, redaction, fuite de données |
| Plugins du Marketplace | Une tâche réutilisable et auditée | pii_mask, export SIEM, notification Slack |
| Flow Studio | Logique conditionnelle et orchestration | Quand interroger Jev, quoi faire de la réponse, comment échouer |
| Jev | Jugement typé et rapide | Quel tier, cette action est-elle cohérente, quelle qualité de réponse |
Quand une décision devient critique et que votre équipe sécurité veut la relire sous forme de code source plutôt que de canvas, déplacez-la d'un flow vers un plugin personnalisé. C'est aussi le bon endroit pour le secret TypeSafe : les secrets de plugin sont stockés comme admin variables, chiffrés dans le navigateur avant d'atteindre Odock et déchiffrés uniquement lors de l'exécution du plugin.
Checklist de déploiement
- Gardez la clé hors du document de flow. Les documents de flow sont de la configuration consultable par les rôles de l'organisation. Placez la clé TypeSafe dans un petit relais que vous contrôlez, ou dans les admin variables d'un plugin personnalisé, pas dans un header de HTTP Request.
- Rendez le relais joignable. Les HTTP Request des flows refusent par défaut les adresses privées et loopback : exposez le relais sur un endpoint autorisé par votre déploiement.
- Minimisez l'état. Exécutez d'abord
pii_masket n'envoyez que les champs utiles à chaque question. - Bornez la latence. Réglez
timeout_msbien en dessous du plafond de 30 secondes ; 500 à 800 ms est un bon point de départ pour les décisions dans le chemin de la requête. - Choisissez le mode d'échec par décision. Le routage échoue ouvert vers le modèle demandé. Les appels d'outils destructifs échouent fermés.
- Pilotez sur une seule clé. Activez le flow depuis l'onglet Automation d'une clé API, testez les cas correspondants, non correspondants, d'échec et de blocage, lisez les traces de flow, puis activez-le pour toute l'organisation.
- Suivez les chiffres. Comparez le coût par requête et les scores de qualité par tier dans les usage records, avant et après.
La vue d'ensemble
Jev est un exemple précoce d'une évolution plus large : les systèmes IA se séparent en juges rapides et en penseurs lents. Les penseurs lents écrivent, planifient et raisonnent. Les juges rapides routent, contrôlent, notent et escaladent. Les entreprises qui laissent chaque application brancher ces juges à sa manière reconstruiront le même problème de gouvernance qu'avec les clés provider.
La gateway est l'endroit où les deux systèmes se rencontrent. Elle voit chaque requête, applique la policy et conserve la trace. Avec Flow Studio et les plugins Odock, un modèle de décision devient une capacité partagée et gouvernée pour chaque équipe et chaque agent, et non une intégration de plus cachée dans le code applicatif.
Sources
- You.com, What is Jev? (présentation de TypeSafe AI, forme de l'API, prix, limites)
- My AI Community, Every AI Agent Starts With a Decision. Jev Just Made It Cheap, 7 octobre 2026
- Sarthak AI, Ways to Use Jev to Make AI Agents More Reliable
- Callstack, Can Jev Make AI Agent Decisions Faster?
- Computerworld, AI inference is getting cheaper, but your agents are getting more expensive, 17 août 2026
- Documentation Odock Flow Studio
- Odock Flow Studio : building blocks
- Architecture des plugins Odock
- Sécurité MCP dans Odock
À retenir
- 1
Jev est un modèle de décision, pas un modèle de chat : réponses typées Choice, Score et oui/non avec probabilités, environ 70 à 500 ms, 0,042 $ par million de tokens d'entrée, tokens de sortie gratuits (chiffres TypeSafe).
- 2
Une grande partie des tokens frontier consommés par les agents sert à des décisions. Les confier à un modèle System One et agir dessus dans la gateway réduit coût et latence sans toucher au code applicatif.
- 3
Flow Studio fournit la plomberie : HTTP Request pour interroger Jev, Switch et If pour brancher, Route Model pour choisir le tier, Abort ou un appel d'approbation pour stopper les actions risquées, et Run Plugin pour masquer les données avant leur sortie.
- 4
Une décision prise dans la gateway s'applique à tous les clients et laisse des preuves : traces de flow, usage records et usage records MCP reliés par un même request id.
- 5
Jev est un filtre, pas une frontière de sécurité : gardez d'abord les contrôles déterministes (grants, allowlists, budgets, SafetySec) et prévoyez un comportement sûr si le service de décision est lent ou indisponible.
Questions fréquentes
Qu'est-ce que Jev ?
Jev est un modèle de décision « System One » publié en accès anticipé par TypeSafe AI le 15 septembre 2026. Il reçoit un état non structuré et renvoie des réponses typées : un Choice parmi des options, un Score sur une échelle ou une probabilité oui/non, chacune avec une confiance calibrée. Il ne génère pas de texte libre.
Odock propose-t-il une intégration native de Jev ?
Non. Jev utilise sa propre API et non un endpoint compatible OpenAI. On l'appelle depuis un nœud HTTP Request de Flow Studio, idéalement via un petit relais qui détient la clé TypeSafe, ou en empaquetant l'appel dans un plugin Odock personnalisé dont le secret est stocké comme admin variable chiffrée.
À quel moment du cycle de vie la décision Jev doit-elle s'exécuter ?
Le routage de modèle se place en pre-route, avant le routage, les budgets et la sécurité d'Odock. Le contrôle des appels d'outils MCP se place en pre-upstream, juste avant l'appel au serveur MCP. La notation des réponses se place en post-response, en asynchrone, sans latence pour l'appelant.
Que se passe-t-il si Jev est lent ou indisponible ?
Le nœud HTTP Request expose une sortie error. Pour le routage, reliez-la au nœud de fin afin que la requête garde son modèle d'origine. Pour les outils destructifs, reliez-la à un nœud Abort pour échouer fermé. Gardez un timeout court, par exemple 800 ms.
Peut-on envoyer des prompts à un modèle de décision externe ?
Seulement après minimisation. Exécutez un plugin de masquage comme pii_mask via un nœud Run Plugin avant le HTTP Request, n'envoyez que les champs utiles à la question et évaluez la gestion des données de TypeSafe comme pour tout fournisseur qui reçoit du contenu de requête.
Placez les décisions rapides là où passe chaque requête
Flow Studio d'Odock permet de router les modèles, de contrôler les appels d'outils MCP et d'appeler des services de décision externes depuis la gateway, avec traces et usage records à chaque exécution.
Articles liés
Comment créer une couche de plugins pour les workflows LLM sans transformer les applications en code de liaison
À mesure que les workflows IA se développent, chaque application finit par ajouter le même code de liaison : filtres de prompts, validateurs de sortie, règles de routage et callbacks. Une couche de plugins au niveau de la passerelle rend cette logique réutilisable.
Lire l'articleLes 6 risques de sécurité MCP auxquels toute entreprise est confrontée en 2026
Le Model Context Protocol a considérablement simplifié l'attribution d'outils aux agents IA. Il a aussi facilité la création de portes d'entrée pour les attaquants. Voici les six risques de sécurité MCP auxquels les équipes en entreprise sont régulièrement confrontées en 2026, ainsi que les contrôles à appliquer au niveau de la gateway pour les neutraliser.
Lire l'articleComment contrôler les coûts LLM avec des clés API virtuelles, des budgets et des quotas
Le moyen le plus rapide de perdre le contrôle de l’économie IA consiste à laisser chaque service appeler directement les providers avec des identifiants partagés. Cet article présente le modèle opérationnel dont les équipes ont besoin à la place.
Lire l'articleLe grand churn des models en 2026 : pourquoi le routing model-agnostic n'est plus optionnel
329+ model releases recensés, et ça continue, un nouveau environ tous les trois jours, des models open-weight désormais compétitifs face aux frontier models. La couche model change plus vite qu'aucune application ne devrait essayer de la suivre à la main. Voici ce que cela signifie sur le plan architectural.
Lire l'article